Die Formulierung „betreibe deine eigene KI-Freundin“ klingt nach einem einzigen Programm. In der Praxis sind es drei Teile, die miteinander sprechen, und wer versteht, welches Teil was tut, spart sich den größten Teil der Frustration.
Die drei Teile
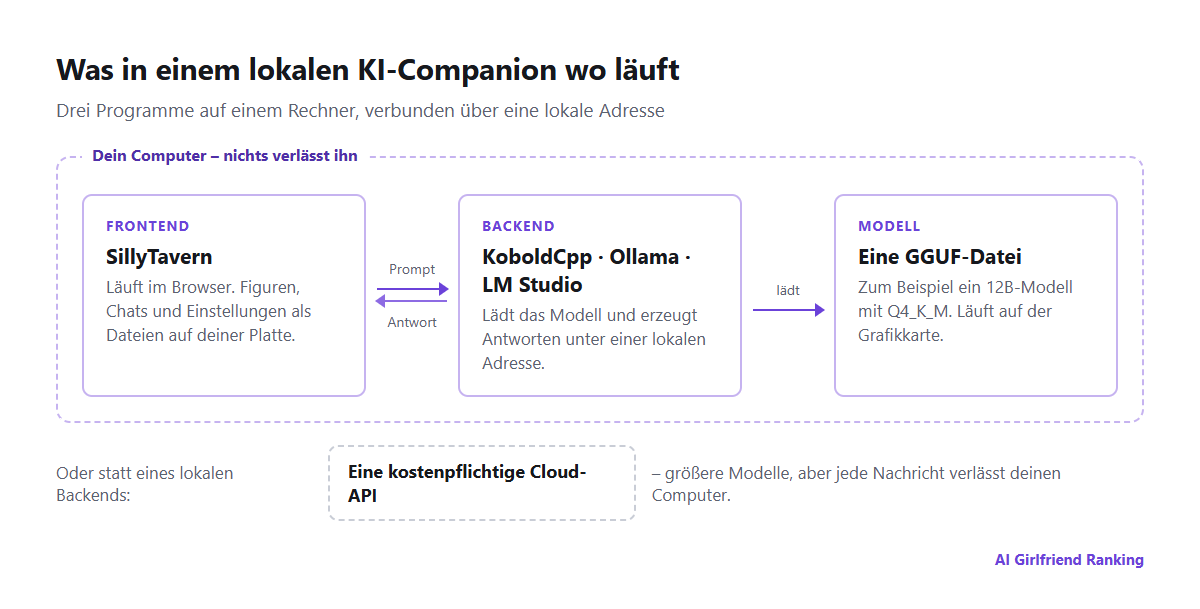
Was in einem typischen lokalen Setup mit wem spricht.
Das Frontend ist das, was du siehst: Chatfenster, Figuren, Avatare, Einstellungen. SillyTavern ist die Standardwahl für Figurenchats. Es läuft in deinem Browser, speichert Figuren und Chats als Dateien auf deiner Platte und lässt sich mit fast jedem Backend verbinden. Text erzeugt es nicht selbst.
Das Backend lädt das Modell und erzeugt die Antworten. KoboldCpp ist ein einzelnes Programm ohne Installation, beliebt für Rollenspiel, weil es jede Generierungseinstellung offenlegt. Ollama ist der einfachste Weg, ein Modell mit wenigen Befehlen zum Laufen zu bringen. LM Studio ist eine Desktop-App mit komfortablem Modellbrowser. Jedes davon stellt das Modell unter einer lokalen Adresse bereit, mit der sich das Frontend verbindet.
Das Modell ist eine große Datei, meist im GGUF-Format, heruntergeladen von Hugging Face. Seine Größe in Parametern – 8B, 12B, 24B – und seine Quantisierung entscheiden, wie gut es ist und welche Hardware es braucht.
Die Hardware-Frage
Ob ein Modell gut läuft, entscheidet der Grafikspeicher (VRAM). Das Modell muss hineinpassen, plus Platz für das Gespräch selbst. Quantisierung schrumpft Modelle, damit sie passen: „Q4_K_M“ ist der übliche Kompromiss zwischen Größe und Qualität.
| Modellgröße | Ca. Speicher bei Q4 | Typische Hardware | Was du erwarten kannst |
|---|---|---|---|
| 7-8B | 5-6 GB | Grafikkarte mit 8 GB | Kohärent, schnell, vergisst Details in langen Szenen |
| 12-14B | 9-10 GB | Karte mit 12 GB | Spürbar bessere Figuren und Prosa |
| 22-24B | 14-16 GB | Karte mit 16-24 GB | Nah an guten gehosteten Apps für Rollenspiel |
| 70B | 40 GB+ | Zwei Karten oder ein Mac mit viel Speicher | Exzellent, langsam und teuer |
Diese Werte sind grob: Längerer Kontext braucht zusätzlichen Speicher. Apple-Silicon-Macs teilen sich den Speicher zwischen Prozessor und Grafik, sodass ein MacBook mit 32 GB Modelle ausführen kann, die eine Grafikkarte mit 12 GB nicht schafft. Passt ein Modell nicht hinein, weicht es auf den Hauptprozessor aus und kriecht dahin – kommen Antworten mit wenigen Wörtern pro Sekunde, geh auf ein kleineres Modell, bevor du eine härtere Quantisierung versuchst. Ein kleineres Modell in guter Qualität schlägt meist ein größeres, das zu stark gequetscht wurde.
Was du gewinnst
- Privatsphäre, die nicht von einer Richtlinie abhängt. Nichts verlässt den Rechner. Keine Aufbewahrungsfrist, kein Training, kein Mitarbeiterzugriff, nichts, das du später löschen müsstest.
- Kein Filter über den des Modells hinaus. Du wählst das Modell, auch solche, die gezielt für Rollenspiel feingetunt sind. Die gesetzliche Untergrenze für Inhalte gilt weiter für dich, aber kein Betreiber legt Regeln obendrauf.
- Kein Abo und keine Credits. Erzeuge so viel, wie du willst.
- Figuren, die dir gehören. Charakterkarten sind gewöhnliche PNG-Bilder mit eingebettetem Charakterbogen. Sie wandern zwischen Frontends und lassen sich dir durch kein Update wegnehmen.
- Stabilität. Ein Modell, das heute funktioniert, funktioniert in fünf Jahren genauso. Niemand kann es dir unterschieben – das Risiko, das in wenn dein KI-Companion über Nacht anders wird beschrieben ist.
Worauf du verzichtest
- Einrichtungszeit. Rechne mit einem Abend bis zum ersten funktionierenden Chat und mit Wochen des Herumprobierens, wenn es dir Spaß macht.
- Das Gedächtnis ist dein Job. Gehostete Apps fassen still zusammen und speichern Fakten über dich. Lokal steuerst du das mit den Lorebooks, Zusammenfassungen und Charakternotizen von SillyTavern – dieselben drei Mechanismen wie in wie das Gedächtnis eines KI-Companions funktioniert erklärt, nur mit offenliegenden Reglern.
- Bilder und Sprache sind eigene Projekte. Bildgenerierung braucht ein eigenes Modell und meist mehr Grafikspeicher; Sprache braucht Spracherkennungs- und Synthese-Werkzeuge. Alles möglich, nichts automatisch.
- Mobil ist umständlich. Du kannst das Frontend im heimischen WLAN vom Handy öffnen. Unterwegs zu nutzen heißt, deinen Rechner ins Internet zu stellen, und das erfordert Sorgfalt.
- Qualitätsgrenze. Die besten gehosteten Modelle sind größer als alles, was die meisten zu Hause betreiben können, besonders bei langfristiger Konsistenz.
Der Mittelweg und sein Haken
Viele betreiben SillyTavern auf dem eigenen Rechner, verbinden es aber mit einer kostenpflichtigen Cloud-API statt mit einem lokalen Modell. Du bekommst die Kontrolle des Frontends und die Figurendateien, viel größere Modelle und eine Abrechnung pro Nachricht, die bei leichter Nutzung günstig sein kann.
Privat ist das allerdings nicht. Jede Nachricht geht an den API-Anbieter, unter dessen Protokollierung, Aufbewahrung und Inhaltsregeln – oft strenger bei Rollenspielinhalten als spezialisierte Companion-Apps. Es ist ein anderer Kompromiss, kein lokales Setup.
Sicherheitsgrundlagen
- Lade Software nur von den offiziellen Projektseiten auf GitHub oder der Website des Projekts herunter.
- Lade Modelle von bekannten Uploadern auf Hugging Face und bevorzuge GGUF-Dateien, die Modelldaten statt Code enthalten.
- Lies die Lizenz des Modells. Manche schränken die kommerzielle Nutzung ein; einige beschränken bestimmte Inhalte.
- Lass SillyTavern an deinen eigenen Rechner oder dein Heimnetz gebunden, es sei denn, du hast ein Passwort gesetzt und verstehst, was du damit freigibst.
SillyTavern wird offen auf GitHub entwickelt.
Für wen es geeignet ist
Betreibe einen Companion lokal, wenn Privatsphäre dein Hauptanliegen ist, du schon leistungsfähige Hardware besitzt oder du Konfigurieren genauso magst wie Benutzen. Bleib bei einer gehosteten App, wenn du Sprache, Bilder und langes Gedächtnis sofort funktionierend willst oder hauptsächlich am Handy chattest. Unser Ratgeber zur Wahl der ersten App behandelt diesen Weg. Viele enden mit beidem: einer gehosteten App für den Komfort und einem lokalen Setup für die Gespräche, die sie lieber nirgends speichern lassen.